UCS Decoder

Décode instantanément les points de code UCS/Unicode en caractères, aidant les développeurs, traducteurs et ingénieurs data à vérifier l’exactitude de l’encodage dans les flux de texte.

Tool coming soon!

We're working hard to get this tool ready for you.

Request Feature / Support
1,568+
Total Calculations Run
< 15ms
Browser Execution Speed
100%
Client-Side Privacy
4.9 / 5.0
User Satisfaction

Worked Example & Common Values

Below is a sample worked calculation demonstrating how UCS Decoder processes input data instantly inside your browser.

Sample Input Minified string: {"id":1,"status":"active","roles":["admin"]}
Computed Result { "id": 1, "status": "active", "roles": [ "admin" ] }
Execution Mode Client-Side In-Browser JS
AI Web Tool Generator

Build Your Own Custom Web Calculator in Seconds

Type what tool or calculator you need below. Our AI will build it instantly for your site.

Popular ideas:
100% FREE No Credit Card Required

À propos de cet outil

Le UCS Decoder convertit les points de code Unicode codés en leurs caractères réels et prend en charge plusieurs notations courantes. Il accepte des entrées sous des formes telles que U+XXXX, \\uXXXX et 0xHEX, en préservant l’ordre et en produisant une chaîne de texte décodée. La logique centrale fait correspondre chaque point de code valide à sa valeur scalaire Unicode, en validant les plages jusqu’à U+10FFFF et en assemblant des paires de substitution lorsque nécessaire. En cas de jetons invalides, le décodeur remplace le caractère de remplacement standard pour préserver l’intégrité de la chaîne. Cet outil est conçu pour la vitesse, permettant des résultats quasi instantanés pour des entrées uniques et des séquences en bloc en un seul passage. Il renvoie également un résumé éventuellement structuré des points décodés pour l’audit ou le traitement en aval. Les cas d’utilisation incluent le nettoyage de données, le débogage des problèmes d’encodage, la préparation à la localisation et la vérification de contenu pour les API ou les journaux. L’approche met l’accent sur un comportement déterministe face aux entrées, avec une gestion claire des espaces et des séparateurs, afin que les notations mixtes puissent être analysées de manière fiable. En fournissant à la fois le texte décodé et une sauvegarde de sécurité en cas d’éléments invalides, il soutient des pipelines robustes sans introduire de corruption des données. Les différenciateurs reposent sur des règles de parsing précises, un décodage conforme à Unicode et des sorties simples adaptées au scripting, aux flux QA et aux outils pour développeurs. Les flux de travail typiques consistent à alimenter une ligne ou un bloc de texte codé, puis à passer en revue le texte décodé aux côtés des résultats au niveau des tokens pour confirmer la exactitude et planifier des remédiations éventuelles. Cet outil est précieux pour les développeurs, les traducteurs et les scientifiques des données qui manipulent fréquemment des données encodées dans divers formats.

Il met l’accent sur la exactitude, la vitesse et l’interopérabilité, permettant une intégration facile dans les pipelines existants et les environnements de notebook.

Comment utiliser

Fournissez la chaîne d’entrée contenant les séquences UCS dans les notations prises en charge (U+XXXX, \\uXXXX, 0xHEX).
L’outil analyse les tokens dans l’ordre, décode les points de code valides et produit la chaîne de texte décodée finale.
Vérifiez la sortie decoded_text et, si nécessaire, examinez les caractères de remplacement pour les tokens invalides.
Si votre entrée contient plusieurs notations, elles seront décodées en un seul passage en conservant l’ordre.
Copiez ou transférez les résultats vers des processus en aval pour la validation ou les tâches de localisation.
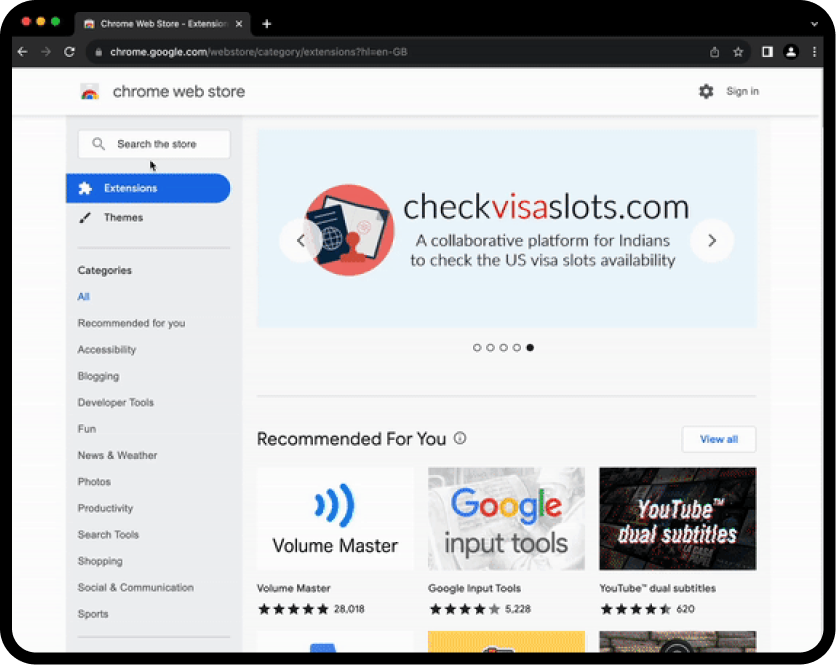
How to use ucs decoder

Frequently Asked Questions

Trouvez des réponses rapides

Quelles notations d’entrée sont prises en charge ?
Les notations prises en charge incluent U+XXXX (jusqu'à U+10FFFF), \uXXXX (échappements de style JS) et les formes 0xHEX. Les jetons peuvent être séparés par des espaces, des virgules ou des sauts de ligne. L’outil normalise tous les jetons valides vers leurs valeurs scalaires Unicode et les décode successivement.
Comment les séquences invalides sont-elles gérées ?
Les jetons invalides ou hors plage sont remplacés par le caractère de remplacement Unicode U+FFFD afin de préserver la longueur et la position de la chaîne. Les jetons valides contribuent leurs caractères décodés, de sorte que les entrées mixtes donnent un résultat raisonnable.
Peut-il décoder plusieurs valeurs à la fois ?
Oui. L’outil traite plusieurs jetons en une seule saisie, en préservant l’ordre et en retournant un seul decoded_text plus des détails optionnels pour audit.
Le résultat est-il sensible à la locale ou à la police ?
Le texte décodé est Unicode et indépendant de toute locale. Le rendu dépend de la police de l’utilisateur, mais la logique de décodage est neutre sur le plan local.

Need to run multiple calculations?

Create a free account today to unlock unlimited daily runs, access advanced parameters, save your history, and request custom features.

Register Free Account

Related Tools

Other useful calculators and utilities you might like
Text & Writing Tools

Calculateur de distance routière

Calculateur de distance routière pour voyageurs, planificateurs logistiques et conducteurs pour esti...

Text & Writing Tools

Convertisseur Spotify vers MP3

Convertit des fichiers audio fournis localement en MP3, permettant l’écoute hors ligne et la compati...

Text & Writing Tools

Calculateur d’âge

Déterminez rapidement l’âge d’une personne à partir de sa date de naissance avec notre calculateur e...

Text & Writing Tools

Calculateur de prix Uber

Estimez le tarif de votre trajet Uber en fonction de la distance, de la durée, du multiplicateur de...

Votre avis compte

Aidez-nous à nous améliorer