UCS Decoder

Dekoder UCS/Unicode-kodepunkter direkte til tegn, hvilket hjælper udviklere, oversættere og dataingenjører med at verificere kodning i tekststrømme.

Tool coming soon!

We're working hard to get this tool ready for you.

Request Feature / Support
1,600+
Total Calculations Run
< 15ms
Browser Execution Speed
100%
Client-Side Privacy
4.9 / 5.0
User Satisfaction

Worked Example & Common Values

Below is a sample worked calculation demonstrating how UCS Decoder processes input data instantly inside your browser.

Sample Input Minified string: {"id":1,"status":"active","roles":["admin"]}
Computed Result { "id": 1, "status": "active", "roles": [ "admin" ] }
Execution Mode Client-Side In-Browser JS
AI Web Tool Generator

Build Your Own Custom Web Calculator in Seconds

Type what tool or calculator you need below. Our AI will build it instantly for your site.

Popular ideas:
100% FREE No Credit Card Required

Om dette værktøj

UCS Decoder konverterer kodede Unicode-kodepunkter til deres faktiske tegn og understøtter flere almindelige noteringer. Den accepterer inddata i former som U+XXXX, \\uXXXX og 0xHEX, hvor rækkefølgen bevares og en afkodet tekststreng produceres. Kernelogikken forbinder hvert gyldigt kodepunkt til dets Unicode-skalærværdi, validerer rækkevidder op til U+10FFFF og konstruerer hvis nødvendigt surrogate-par. Ved ugyldige tokens erstattes med erstatningstegnet for at bevare længde og position. Værktøjet er designet til hastighed og leverer næsten øjeblikkelige resultater for både enkelt- og sekventielle input i én afgang. Det returnerer også et valgfrit struktureret resume af dekodede punkter til revision eller viderebehandling. Anvendelsestilfælde inkluderer datasanering, fejlfinding af kodning, forberedelse til lokalisering og indholdsgodkendelse for API’er eller logs. Tilgangen lægger vægt på deterministisk adfærd og tydelig håndtering af mellemrum og separatorer, så blandede notations kan analyseres pålideligt. Ved at levere både dekodet tekst og en sikkerhedsfallback ved ugyldige elementer understøtter den robuste pipelines uden datakorruption. Differentiererne er præcise parsing-regler, Unicode-kompatibel decoding og klare outputs til scripting, QA-workflows og udviklerværktøjer. Typiske workflows indebærer at indtaste en række eller blok kodet tekst og derefter gennemgå den dekodede tekst sammen med token-detaljer for at bekræfte korrekthed og planlægge afhjælpninger. Dette værktøj er værdifuldt for udviklere, oversættere og dataforskere, der ofte arbejder med kodede data i forskellige formater.

Det fremhæver korrekthed, hastighed og interoperabilitet og muliggør nem integration i eksisterende pipelines og notebook-miljøer.

Sådan bruges

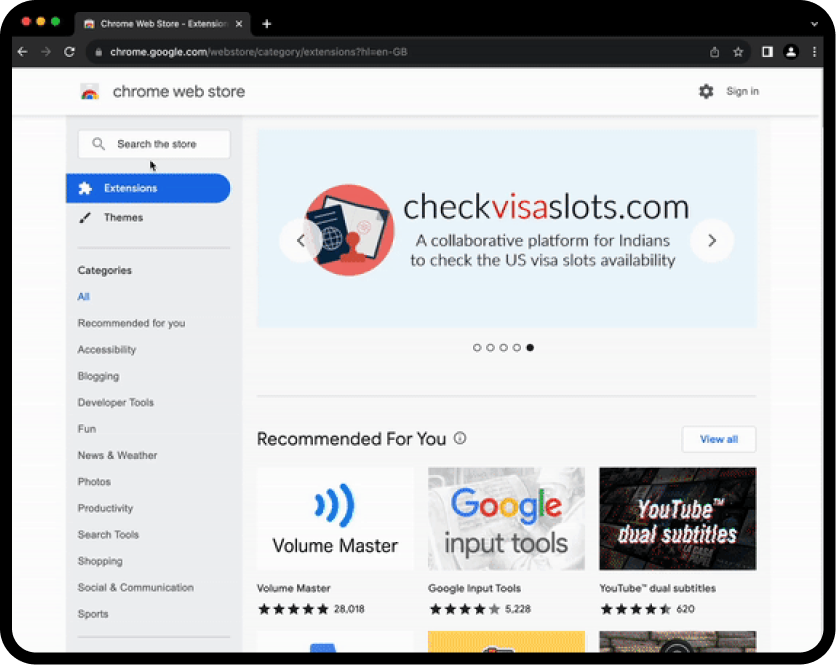
Indtast inddata-strengen, der indeholder UCS-sekvenser i understøttede notationsformer (U+XXXX, \\uXXXX, 0xHEX).
Værktøjet analyserer tokens i rækkefølge, dekoder gyldige kodepunkter og konstruerer den endelige dekodede tekst.
Tjek outputtet decoded_text og gennemgå eventuelle erstatningstegn for ugyldige tokens.
Hvis din indtastning indeholder flere notationsformer, dekodes de i ét gennemløb i den ordnede rækkefølge.
Kopier eller viderefør resultaterne til downstream processer til validering eller lokalisering.
How to use ucs decoder

Frequently Asked Questions

Find hurtige svar

Hvilke indtastningsnoteringer understøttes?
Understøttede noteringer inkluderer U+XXXX (op til U+10FFFF), \\uXXXX (JS-stil escapes) og 0xHEX-former. Tokens kan adskilles af mellemrum, kommaer eller linjeskift. Værktøjet normaliserer alle gyldige tokens til deres Unicode-skalære værdier og dekoderer dem i rækkefølge.
Hvordan håndteres ugyldige sekvenser?
Ugyldige eller uden for rækkevidde tokens erstattes med Unicode-erstatningstegnet U+FFFD for at bevare længde og position. Gyldige tokens bidrager med deres dekodede tegn, så blandet input giver et rimeligt resultat.
Kan det dekode flere værdier samtidig?
Ja. Værktøjet behandler flere tokens i én indtastning, bevarer rækkefølgen og returnerer et enkelt decoded_text plus detaljer per token til revision.
Er resultatet lokalisations- eller skrifttype- afhængigt?
Den dekodede tekst er Unicode og uafhængig af locale. Rendering afhænger af brugerens skrifttype, men selve dekodningslogikken er lokalefri og fokuserer på korrekt kodepunktoversættelse.

Need to run multiple calculations?

Create a free account today to unlock unlimited daily runs, access advanced parameters, save your history, and request custom features.

Register Free Account

Related Tools

Other useful calculators and utilities you might like
Text & Writing Tools

Vejafstandscalculator

Et vejafstandscalculator til rejsende, logistikplanlæggere og chauffører til hurtigt at estimere afs...

Text & Writing Tools

Spotify til MP3-konverter

Konverterer lokalt leverede lydefiler til MP3, muliggør offline-lytning og tvær-enheds-kompatibilite...

Text & Writing Tools

Aldersberegner

Beregn hurtigt en persons alder baseret på fødselsdato med vores gratis online calculator, egnet til...

Text & Writing Tools

Uber prisberegner

Estimer din Uber-turpris baseret på distance, varighed, stigningsmultiplikator, basispris og køretøj...

Din feedback betyder noget

Hjælp os med at forbedre