Web Scraper

Ett webbskrapningsverktyg för SEO-analytiker och forskare för att extrahera strukturerad siddata över flera URL:er.

Tool coming soon!

We're working hard to get this tool ready for you.

Request Feature / Support
768+
Total Calculations Run
< 15ms
Browser Execution Speed
100%
Client-Side Privacy
4.9 / 5.0
User Satisfaction
AI Web Tool Generator

Build Your Own Custom Web Calculator in Seconds

Type what tool or calculator you need below. Our AI will build it instantly for your site.

Popular ideas:
100% FREE • No Credit Card Required

About This Tool

Verktyget utför automatisk extraktion av strukturerad data från offentliga webbsidor för att stödja SEO, innehållsgranskningar och marknadsforskning. Den tar emot en batch med URL:er och en mappning av fält till selektorer (CSS eller XPath), tillämpar selektorerna på varje sida och hämtar värden som titlar, metataggar, rubriker, priser och schema.org-attribut. Den underliggande logiken betonar noggrannhet, spårbarhet och exportberedskap, vilket möjliggör reproducerbar datainsamling över webbplatser. Sidor hämtas och tolkas till ett DOM-träd och varje konfigurerad selektor används för att erhålla önskat värde; resultaten normaliseras (trimma, datum- och sifferformat standardiseras) och sammanställs. Valfri rendering av dynamiskt innehåll via en headless browser utökar täckningen för klient-sidodata. Utdata kan exporteras som JSON, CSV eller NDJSON, lämpligt för inmatning i data-pipelines eller analytiska verktyg. Efterlevnad av robots.txt och konfigurerbara hastighetsbegränsningar minimerar påverkan på målsajter. Per-objekt metadata som extraktionsförtroende och sidor-resuméer underlättar validering. Användningsfall inkluderar konkurrenskraftig prisövervakning, metadata-validering, produktdataposter och innehållsmigrationsanalyser. Avancerade funktioner inkluderar samtidighetskontroller och robust felrapportering vid stora dataset.

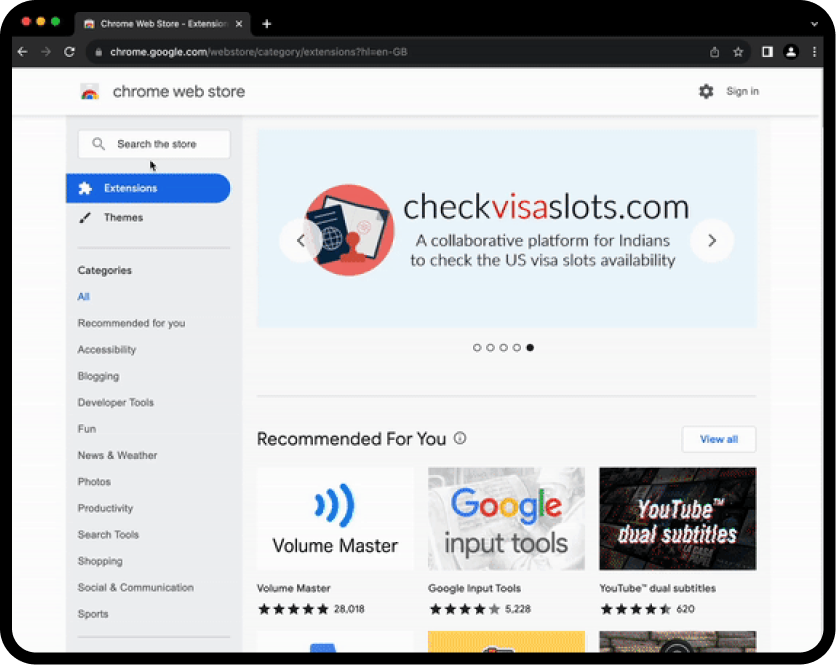
How to Use

  1. Ange mål-URL:er och en selectors-mapp för varje fält som ska extraheras.
  2. Konfigurera inställningar: max_pages, obey_robots_txt, delay_ms och valfri headless rendering.
  3. Starta skrapningen: kör batch-extraktion med konfigurerad samtidighet.
  4. Granska utdata: kontrollera scraped_items och metadata för fullständighet.
  5. Exportera resultat: välj JSON, CSV eller NDJSON för vidare bearbetning.
How to use scraper tool web

Frequently Asked Questions

Find Quick Answers

Vilka data kan skrapas?
Alla värden som är synliga i sidans DOM och kan väljas med CSS/XPath-selektorer, inklusive titlar, beskrivningar, priser, rubriker och strukturerade data som schema.org-attribut. Dynamiskt innehåll kan fångas när rendering är aktiverad.
Följer det robots.txt?
Ja. Standardinställningen kontrollerar robots.txt och utesluter blockerade URL:er, om inte en överskrivning är explicit konfigurerad.
Kan det hantera dynamiskt innehåll?
Ja, alternativt. När rendering är aktiverad används en headless browser för att köra JavaScript före extraktion.
Vilka exportformat stöds?
JSON, CSV och NDJSON. Varje post motsvarar de konfigurerade selektorerna med eventuella metadata och tidsstämplar.

Need to run multiple calculations?

Create a free account today to unlock unlimited daily runs, access advanced parameters, save your history, and request custom features.

Register Free Account

Related Tools

Other useful calculators and utilities you might like
Web & SEO Tools

Spotify till MP3-omvandlare

Konverterar lokalt tillhandahållna ljudfiler till MP3, vilket möjliggör offline-lyssning och cross-e...

Web & SEO Tools

Väglängdsberäknare

Ett väglängdsberäknar-verktyg för resenärer, logistikutformare och förare att snabbt uppskatta avstå...

Web & SEO Tools

Åldersräknare

Bestäm snabbt en persons ålder baserat på födelsedatum med vår gratis online-räknare, lämpad för pri...

Web & SEO Tools

Valutakonverterare

Omvandla belopp snabbt mellan olika valutor med vår kostnadsfria online valutakonverterare, perfekt...

Your Feedback Matters

Help Us to Improve