Data Scraper

Un outil de scraping de données pour les analystes SEO, chercheurs et développeurs afin d’extraire le contenu structuré des pages Web pour analyse, rapports et enrichissement des données.

Tool coming soon!

We're working hard to get this tool ready for you.

Request Feature / Support
2,736+
Total Calculations Run
< 15ms
Browser Execution Speed
100%
Client-Side Privacy
4.9 / 5.0
User Satisfaction
AI Web Tool Generator

Build Your Own Custom Web Calculator in Seconds

Type what tool or calculator you need below. Our AI will build it instantly for your site.

Popular ideas:
100% FREE • No Credit Card Required

À propos de cet outil

L’outil Data Scraper permet une extraction programmatique de contenu structuré à partir de toute page Web cible en configurant une URL, un ensemble de définitions de champs et un format de sortie. Il prend en charge plusieurs descripteurs de champ (name, selector, data_type, attribute) et renvoie des enregistrements au format JSON ou CSV. Il convient pour les audits SEO, les études de marché et les pipelines d’enrichissement des données. Il fonctionne mieux sur les pages avec du HTML statique; pour les contenus dynamiques lourds, il peut être nécessaire d’avoir des pages pré-rendues ou un accès via API.\n\nConception: l’outil envoie la requête à l’URL spécifiée, applique le sélecteur CSS de chaque champ pour localiser les données, extrait le texte ou un attribut, normalise les espaces, convertit les nombres ou les dates et déduplique les enregistrements par une clé si fournie. Il peut paginer sur plusieurs pages jusqu’à max_pages. Les sélecteurs invalides renvoient des valeurs nulles; les pages manquantes sont ignorées.\n\nQui en bénéficie: les analystes SEO, les data scientists, les responsables produits et les chercheurs; les cas d’utilisation typiques incluent le scraping des prix, les catalogues de produits, les métadonnées d’articles et les listes de concurrents. L’outil prend en charge les exécutions automatisées, standardise les sorties et s’intègre dans les pipelines de données.\n\nFonctionnalités clés: descriptors multi-champs, validation des entrées, formats de sortie configurables, gestion des erreurs, limitation de débit, considération du robots.txt, et schémas prêts à l’export. Un différenciateur est la logique d’extraction explicite par champ avec une normalisation robuste et des formats JSON/CSV prêts à l’emploi pour l’analyse et les outils BI.\n\nExemples: extraire le nom de produit et le prix d’une fiche produit, constituer un dataset des titres d’articles et des dates de publication, ou rassembler des offres d’emploi avec localisation et date pour l’analyse du marché.

Comment utiliser

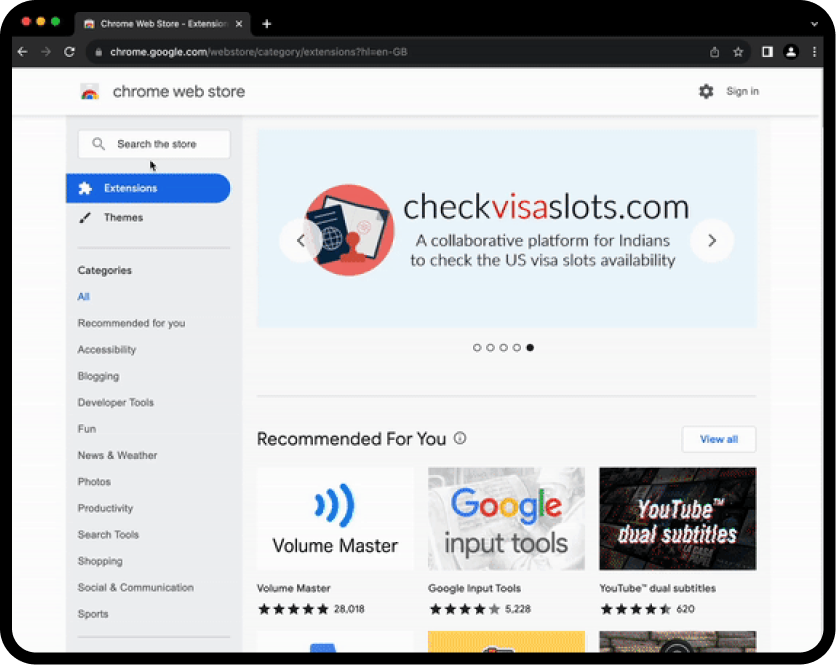
  1. Fournissez les entrées: URL et définitions de champs (name, selector, data_type, attribute).
  2. Choisissez le format de sortie (JSON ou CSV) et éventuellement max_pages pour la pagination.
  3. Lancez l’extraction: l’outil interroge les pages et applique les sélecteurs pour collecter les données.
  4. Vérifiez les sorties: confirmez le nombre d’enregistrements et gérez les valeurs nulles ou les conversions de type.
  5. Exportez les résultats dans votre pipeline de données ou votre stockage.
How to use data scraper tool

Frequently Asked Questions

Trouvez des réponses rapides

Peut-il gérer des pages dynamiques ou du contenu rendu par JavaScript ?
L’outil est conçu pour des pages HTML statiques. Pour le contenu dynamique, utilisez des pages pré-rendues ou fournissez un endpoint API si disponible. Les sites fortement basés sur JavaScript peuvent nécessiter des méthodes d’accès aux données alternatives ou un service de rendu.
Quelles sorties sont prises en charge et comment les champs sont-ils définis ?
Les sorties peuvent être JSON ou CSV. Les champs sont définis dans des descripteurs avec un nom, un sélecteur CSS, un data_type (string, number, date) et un attribut optionnel à extraire (texte ou href, etc.).
Comment les erreurs et les données manquantes sont-elles gérées ?
Si un sélecteur ne correspond pas, la valeur correspondante est null. Les pages inaccessibles ou les URL invalides génèrent des erreurs. Les données incomplètes sont autorisées; les processus en aval doivent gérer les nulls et les conversions de type.
Y a-t-il des limites quant au nombre de pages et à la limitation de débit ?
max_pages contrôle la profondeur de la pagination; l’outil peut appliquer une stratégie de backoff lors de réponses à latency élevée ou sujettes à une limitation de débit afin d’éviter le blocage.

Need to run multiple calculations?

Create a free account today to unlock unlimited daily runs, access advanced parameters, save your history, and request custom features.

Register Free Account

Related Tools

Other useful calculators and utilities you might like
Web & SEO Tools

Convertisseur Spotify vers MP3

Convertit des fichiers audio fournis localement en MP3, permettant l’écoute hors ligne et la compati...

Web & SEO Tools

Calculateur de distance routière

Calculateur de distance routière pour voyageurs, planificateurs logistiques et conducteurs pour esti...

Web & SEO Tools

Calculateur d’âge

Déterminez rapidement l’âge d’une personne à partir de sa date de naissance avec notre calculateur e...

Web & SEO Tools

Convertisseur de devises

Convertissez rapidement des montants entre différentes monnaies avec notre convertisseur de devises...

Votre avis compte

Aidez-nous à nous améliorer